62,7 y 99,9: el mismo modelo, el mismo examen, dos notas
OpenAI publicó un 99,9 % en ARC-AGI-3 para GPT-6 Astra. ARC Prize midió 62,7 % el mismo día. La diferencia es el arnés, y explica por qué las tablas de benchmarks ya no comparan modelos.
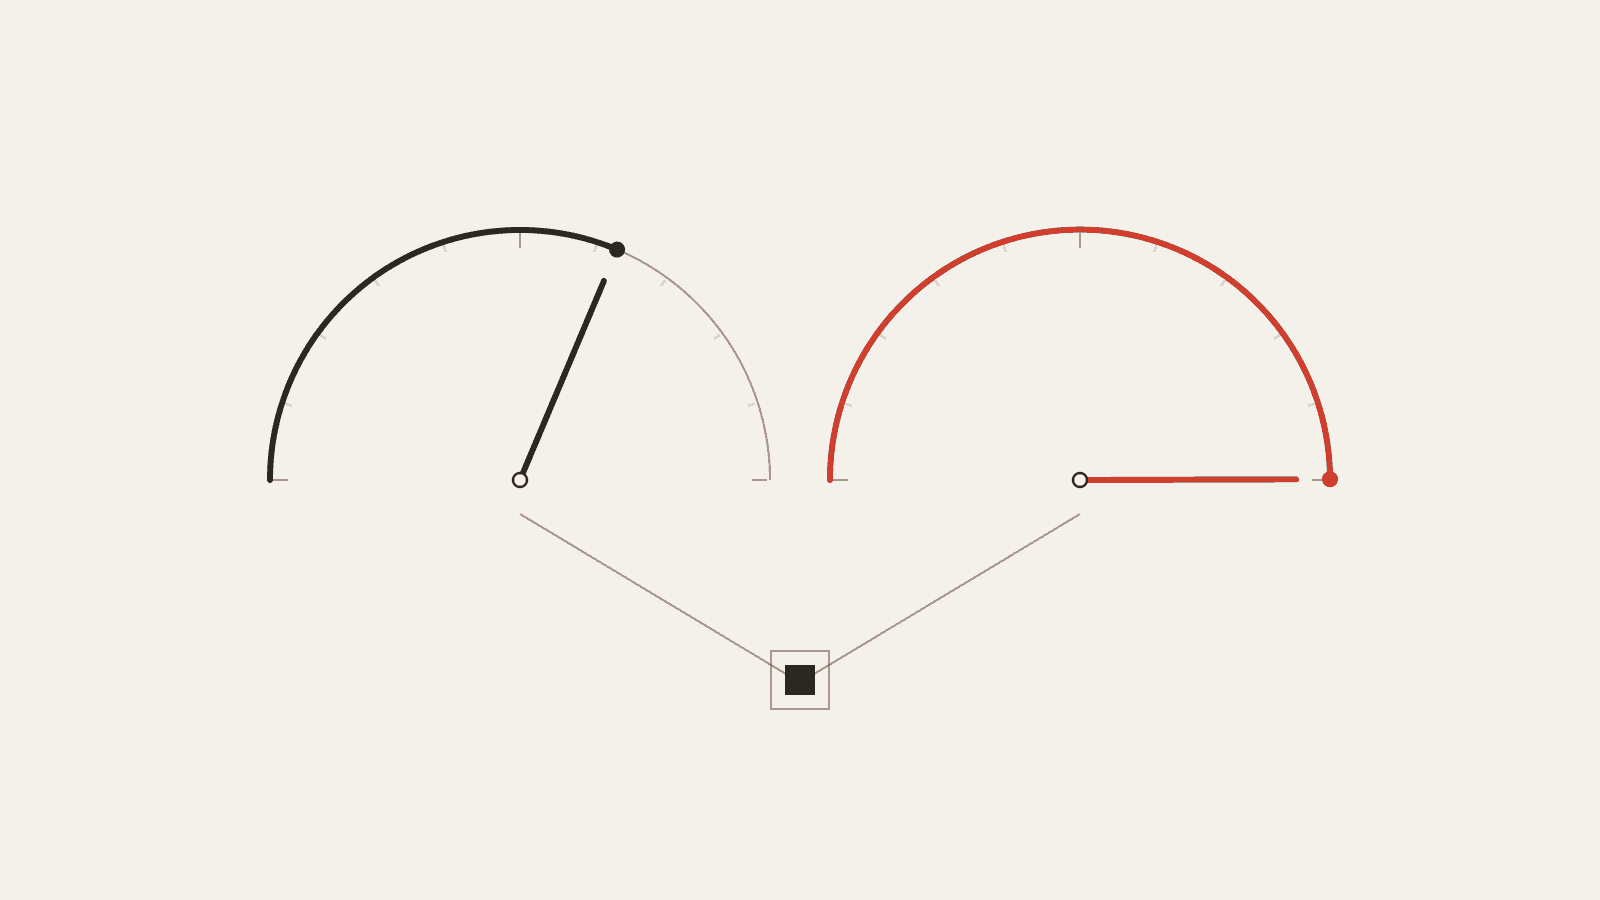
OpenAI publicó un 99,9 % en ARC-AGI-3 para GPT-6 Astra. ARC Prize midió 62,7 % el mismo día. La diferencia es el arnés, y explica por qué las tablas de benchmarks ya no comparan modelos.
Google publicó un whitepaper de 51 páginas sobre el nuevo ciclo de vida del software con vibe coding. El marco conceptual —el espectro, Agente = Modelo + Harness, el modelo fábrica— es excelente. El aparato estadístico se cae a la primera pregunta. Reseña capa por capa, con las nueve cifras de cabecera trazadas a su…
Graphify convierte un repositorio en un grafo de conocimiento determinista, sin embeddings y sin coste de LLM. Su benchmark es de los mejores del sector — y contiene la fila que desmonta su propio titular: cuatro milésimas sobre un híbrido RRF clásico. Análisis técnico del pipeline, lectura crítica de las cifras y el problema de…
Un paper de agosto propone dejar de instalar skills en los agentes de IA y empezar a llamarlas por su nombre. La idea es buena y el diagnóstico es mejor. La implementación lleva tres semanas en GitHub, tiene dos forks y un paquete que todavía no existe.
Dieciséis bacteriófagos diseñados por un modelo generativo infectaron y mataron E. coli. El peligro no es la máquina que escribe genomas: es que la cerradura que nos protegía estaba en otra puerta, y lleva años reconociendo caras.
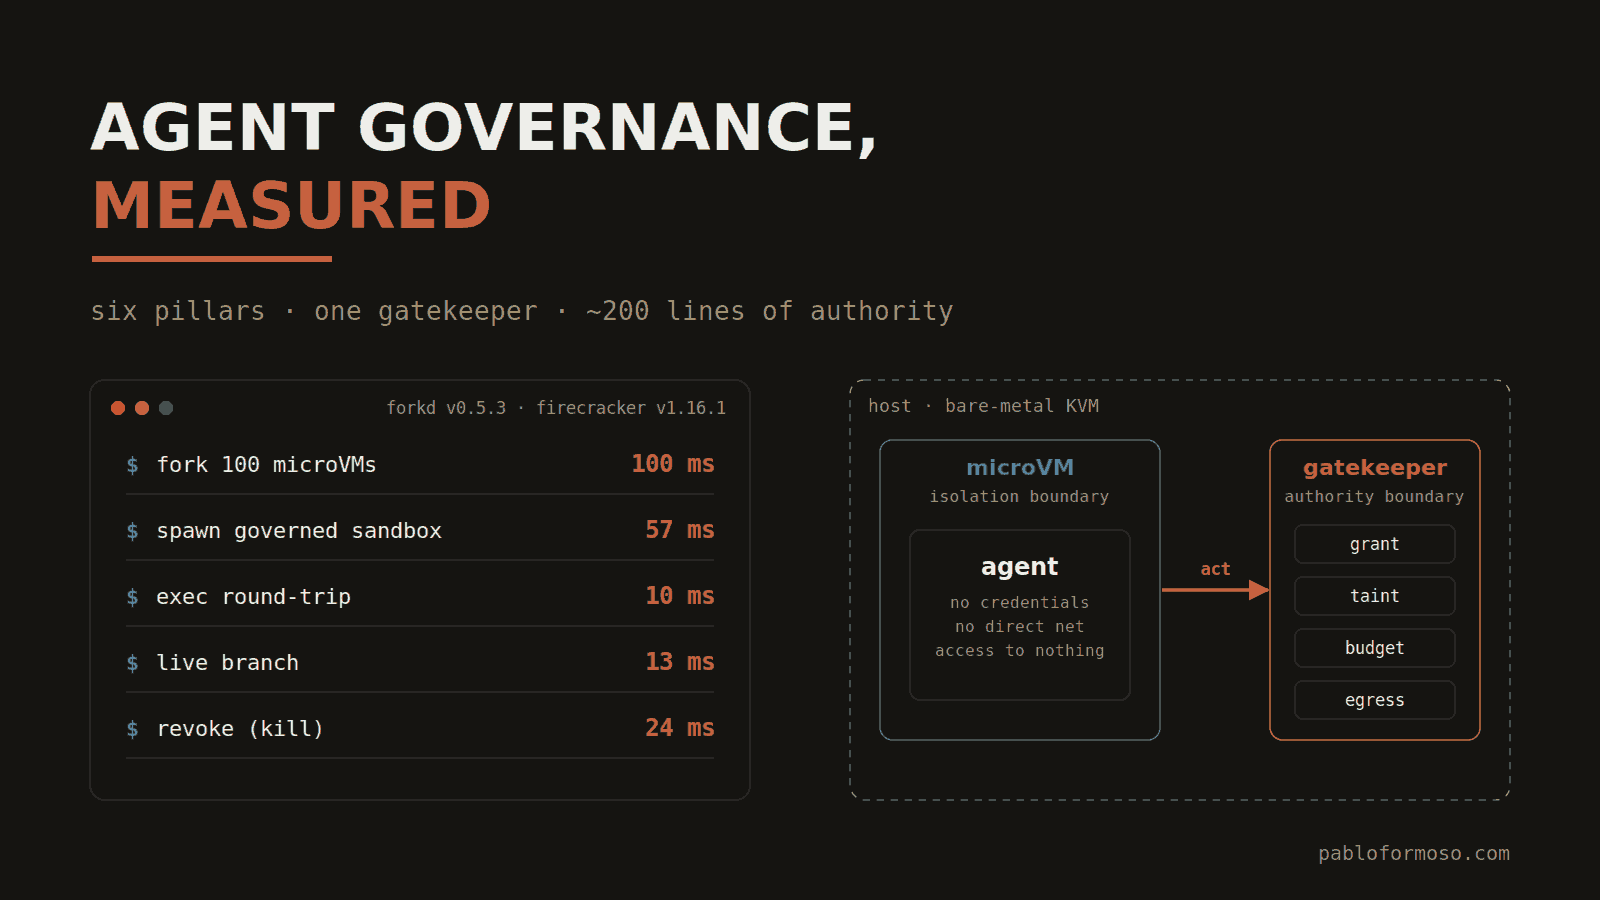
El gobierno de agentes suele discutirse como doctrina. Nosotros lo bajamos a un banco de pruebas: un gatekeeper de ~200 líneas, microVMs clonadas en caliente y cuatro modelos intentando —sin saberlo— saltarse las reglas. Los números, la matriz de inyección de prompt y las dos fugas que más nos enseñaron.
Los runtimes de agentes han convergido en la misma arquitectura y casi el mismo precio. La pregunta interesante ya no es cuál comprar: es qué hace cumplir de verdad el que ya tienes, y dónde empieza lo que te toca construir a ti.
Amodei aclara que Anthropic nunca pidió prohibir los modelos de pesos abiertos. Su texto es más razonable de lo que decían los titulares —y aun así, el debate real está en otro sitio: en si queremos un monocultivo eficientísimo o un banco de semillas.
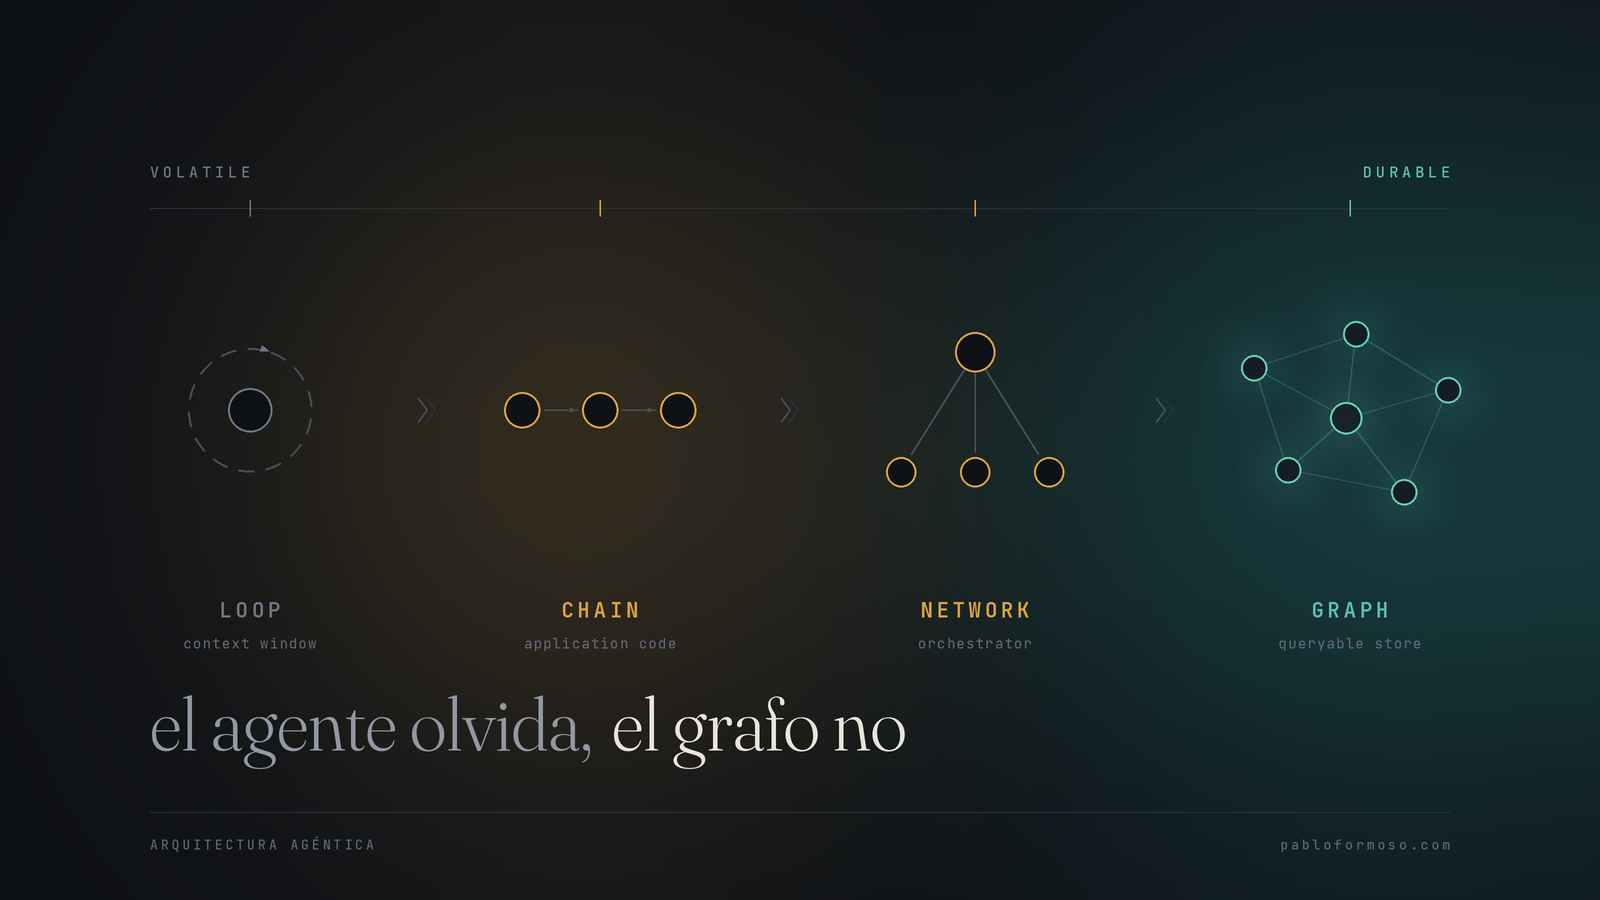
Los cuatro patrones de Andrew Ng siguen siendo el vocabulario correcto, pero el eje real de la arquitectura agéntica no es cuántos agentes tienes: es dónde vive el estado. Un recorrido honesto de loops a grafos, con lo que ha cambiado desde 2024.
Loop engineering sin humo: la anatomía de un bucle autónomo, cómo monto el mío con un tablero de GitHub y subagentes, y las piezas de Claude Code que lo hacen posible.