
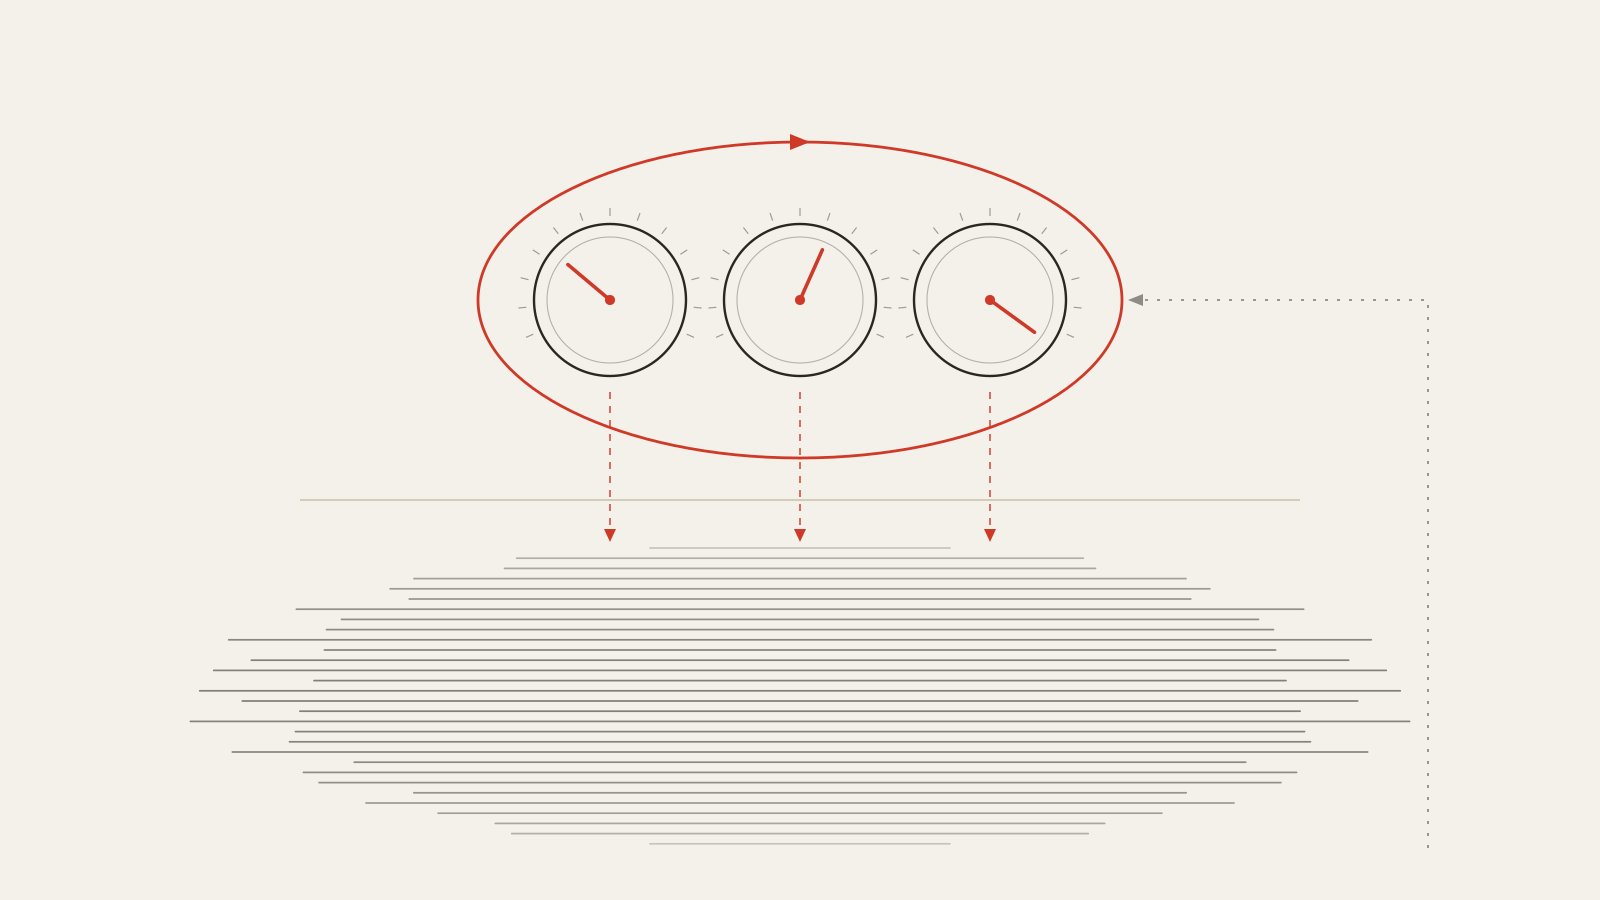
Un agente de Meta mueve los diales de un recomendador en producción cada tres días. No rankea ítems ni reentrena modelos: toca la superficie de control, unas diez llamadas por ciclo, y el coste estimado del bucle entero se queda en decenas de dólares. Anexo a la serie de los bucles.
Esta serie ha ido subiendo un escalón por entrega. Primero fue el bucle: sensor, controlador, efector, medición, otra vuelta — homeostasis con GPU vaciando un backlog mientras duermes. Luego el grafo, cuando quedó claro que el agente olvida y el grafo no. Y en la tercera, el grafo dejó de ser un dibujo para convertirse en el programa: nodos que piensan, aristas que son código, juicio × topología.
Las tres tenían algo en común que no dije en voz alta: el bucle vivía dentro de mi ordenador. El backlog era mío, el repositorio era mío, y si la criatura la liaba, la liaba en una rama.
Este anexo va de lo que pasa cuando ese mismo patrón sale del IDE y se enchufa a un sistema que sirve a miles de millones de personas. El 2 de septiembre, diez autores de Meta AI subieron a arXiv un paper corto y muy poco pretencioso llamado CORAL — Constraint-Optimized Recommender via an Agentic Loop —, aceptado en el workshop OARS de RecSys ’26. Es, hasta donde yo sé, la primera descripción pública decente de un bucle agéntico corriendo en un recomendador de producción, con experimentos A/B de verdad y números medidos.
Y lo interesante no son los números. Es dónde decidieron enchufar el modelo.
Dos planos, y casi todo el mundo elige el equivocado
Cuando alguien dice «vamos a meter un LLM en el recomendador», por defecto piensa en una de estas dos cosas: que el modelo ordene los ítems, o que el modelo entienda al usuario para ordenar mejor los ítems. En ambos casos el LLM acaba en el plano de datos: en el camino que recorre cada petición, entre el usuario y lo que ve.
Ese plano tiene una propiedad que lo estropea todo: el coste escala con el tráfico. Una llamada por petición, o por ítem, o por usuario. Multiplica eso por una superficie de miles de millones y ya no estás haciendo ingeniería, estás haciendo una hoja de cálculo que no cuadra. Añade la latencia: el modelo pasa a estar en la ruta crítica de algo que tiene que responder en milisegundos.
CORAL hace lo contrario. El modelo solo observa el sistema a través de señales agregadas. Y lo que toca son los mandos.
Un recomendador grande, dicen los autores, «no es un solo modelo, sino un sistema grande y multietapa: recuperación de candidatos, ranking y serving». Ese sistema está lleno de perillas: cuánto presupuesto de recuperación se lleva cada fuente de candidatos, qué tratamiento de servicio recibe cada segmento de usuarios, cuánta agresividad, cuánta caché, cuánto prefetch. El paper llama a ese conjunto la superficie de control, y a cada perilla una unidad de control. Una frase del paper, dicha sobre los repartos de presupuesto entre fuentes de recuperación, resume por qué esto importa tanto y por qué nadie lo mira: «suelen fijarse a mano y se revisan rara vez».
Ahí es donde vive el agente. En el plano de control. No decide qué ve un usuario: decide cómo está configurado el sistema que decide qué ve un usuario.
La consecuencia económica es tan bestia que merece leerse despacio, y la desarrollo más abajo con la fórmula. Pero el titular es este: en el plano de control, el número de llamadas al modelo no depende del tráfico. Depende de en cuántos grupos hayas partido tu superficie de control. Un puñado por ciclo. Los mismos si tienes mil usuarios que si tienes mil millones.
La anatomía, pieza a pieza
Si has leído la primera entrega, el esqueleto te va a resultar familiar hasta la incomodidad. Es exactamente el mismo bucle, con otros nombres y otro presupuesto.
Lo que observa. Estadísticas de operación agregadas por unidad de control, más los cambios recientes. Nada de eventos individuales.
Lo que recuerda. Aquí está la primera pieza que merece la pena robar. La memoria no es un cajón: son tres almacenes con papeles distintos.
- El almacén de observaciones guarda las estadísticas crudas por unidad.
- El almacén de valoraciones guarda «juicios concisos, en lenguaje natural, sobre qué partes del sistema van bien o mal y cómo evoluciona su comportamiento».
- El almacén de decisiones guarda las configuraciones que el agente desplegó junto con los resultados que después se les atribuyeron.
Ese tercero es el que convierte el montaje en un bucle de verdad y no en un generador de propuestas con buena prosa. Un agente que recuerda lo que hizo pero no lo que pasó después no está aprendiendo: está redactando. La memoria horizonte son m = 3 ciclos.
Con qué actúa. Un conjunto pequeño de herramientas deterministas —cinco, si contamos la que despliega—, y el reparto de papeles es la tesis de la tercera entrega llevada al extremo — guarda los agentes para el juicio, la fontanería es código:
| Herramienta | Qué hace | Quién manda |
|---|---|---|
| Análisis | Calcula y resume estadísticas a partir de las observaciones crudas | Código |
| Recuperación | Saca de la memoria el histórico relevante | Código |
| Atribución | Estima el efecto de la configuración anterior | Código |
| Optimizador con restricciones | Proyecta la propuesta sobre el conjunto factible por presupuesto | Código |
| Despliegue | Aplica la configuración aceptada al recomendador vivo | Código |
El modelo no calcula. El modelo lee lo que calcularon las herramientas, razona sobre ello, propone un ajuste acotado y escribe por qué. Esa justificación no es decoración: es lo que permite que un humano supervise y lo que alimenta la atribución del ciclo siguiente.
Cada cuánto. k = 3 días por ciclo. Y me gusta que sean honestos sobre de dónde sale ese número: «lo bastante largo para que el efecto de una configuración aflore en las métricas, lo bastante corto para que el agente actúe pronto sobre lo que observa». Y a continuación, la frase que la mitad de los papers se ahorraría: «elegimos estos valores como valores por defecto razonables, no ajustándolos».
Qué cierra el bucle. Un experimento A/B. No un test que pasa en verde: un experimento en producción sobre millones de usuarios cuyo resultado se escribe en el almacén de decisiones y se convierte en el contexto del ciclo siguiente.
El modelo propone, la aritmética dispone
Esta es la pieza que me llevo puesta a cualquier bucle que monte a partir de ahora, y es de una simpleza que da rabia no haberla escrito antes.
El agente no despliega lo que propone. Propone ajustes acotados por unidad, y esa propuesta pasa por un optimizador que devuelve «la configuración más cercana que satisface el presupuesto de operación — la proyección de la propuesta sobre el conjunto factible {s : c_t(s) ≤ B}».
Léelo otra vez con ojos de operaciones. La restricción de presupuesto no se le pide al modelo. No está en el prompt como un «por favor, no te pases». No depende de que el modelo haya entendido bien la aritmética un martes por la tarde. Está en la estructura: cualquier cosa que el modelo proponga, sale del optimizador siendo factible por construcción.
Es la diferencia entre un guardarraíl y un consejo. Y es, creo, la razón real por la que esto se puede desplegar en producción sin que a nadie le tiemble el pulso: el peor caso de un modelo alucinando no es una factura de siete cifras, es una propuesta mala que el proyector convierte en una configuración factible mediocre, que el A/B mide como neutra y que el ciclo siguiente corrige.
Los autores lo dicen con menos drama: la división hace que «el modelo aporte juicio mientras las herramientas aportan cálculo y garantías duras».
La función de recompensa es un A/B
El primer caso de estudio es un servicio de recomendación de vídeo. Las unidades de control son las fuentes de recuperación — los distintos mecanismos que aportan candidatos — y la configuración asigna a cada una un multiplicador de presupuesto dentro de un rango acotado. El coste de operación es el presupuesto total de recuperación consumido.
Tres rondas, medidas con A/B:
- Ronda 1, propuesta zero-shot formada a partir de una sola ventana de estadísticas: +0,13% de tiempo de visionado, sesiones neutras.
- Ronda 2: el agente repartió presupuesto de forma más agresiva entre fuentes, se pasó de frenada, y el efecto medido fue neutro.
- Ronda 3, que agrega varios ciclos de decisión y es la configuración que quedó desplegada: +0,15% de tiempo de visionado, +0,16% de sesiones en todos los usuarios y +0,77% de sesiones en el mercado más grande. Todo ello sin coste de serving adicional, porque la reasignación consolidó el presupuesto en vez de ampliarlo.
Y aquí está el detalle que casi todo el mundo leería como un fallo. El paper lo señala él mismo, y con razón: «esta progresión no es monótona — la segunda ronda no mejoró la primera — y sin embargo es precisamente el comportamiento que el bucle está diseñado para producir».
Piénsalo desde la primera entrega. Un bucle que solo sube no es un bucle: es una racha. Lo que demuestra que hay realimentación de verdad es exactamente esto — que el agente se pasó, que el A/B se lo dijo, que lo leyó en su propio almacén de decisiones y que la ronda siguiente corrigió. El error medido es la señal.
Después extendieron el montaje para dar asignaciones distintas por segmento — nivel de actividad y antigüedad de la cuenta — y ahí sale la cifra que a mí más me dice: +0,23% de sesiones en usuarios nuevos de baja señal. El agente movió presupuesto hacia las fuentes que se apoyan en señales de contenido y contexto, que son las que aguantan cuando del usuario no sabes casi nada, y lo quitó de las que dependen del historial. Es una decisión que un ingeniero razonable habría tomado igual. La gracia es que nadie la tomó, porque esa perilla estaba fijada a mano y casi nunca se revisaba.
El otro tornillo: capacidad de servicio
El segundo caso es un servicio distinto y una clase de decisión distinta, con el mismo bucle. Aquí las unidades de control son segmentos de usuario, y a cada uno se le asigna un tratamiento de servicio de un menú discreto: variantes en agresividad de recuperación, en ranking, en caché y en prefetch. La restricción es un tope fijo de coste de servicio.
- Ronda 1: trabajando sobre un subconjunto de segmentos, el agente redujo el coste de servicio «ahorrando millones de dólares en gasto de capacidad anualizado».
- Ronda 2: leyendo ese resultado contra su decisión previa, el agente reconoció que el mismo cambio se podía aplicar con seguridad a más segmentos, amplió la asignación y aumentó en un 44% el ahorro de la primera ronda, dejando el engagement «estadísticamente sin cambios».
Cuidado con ese 44%, que es el número que más fácil se cuenta mal: no es un ahorro del 44%. Es un 44% más de ahorro que en la ronda anterior. Si la primera ronda ahorró X, la segunda ahorró X·1,44.
Que el mismo harness sirva para empujar engagement en un sitio y para recortar coste en otro es el argumento de generalidad del paper, y es razonable: los autores lo presentan como evidencia de que «un solo bucle agéntico puede asumir el trabajo de optimización continua que tradicionalmente han hecho ingenieros de algoritmos humanos, con un camino que va de la operación supervisada por humanos a la operación autónoma bajo guardarraíles».
La factura: por qué esto sale por decenas de dólares
Aquí está la tesis del artículo, y es puramente arquitectónica.
El coste de todo el montaje es:
Coste = (T / k) · C · (τ_in · p_in + τ_out · p_out)donde T son los días de despliegue, k la cadencia en días, C el número de llamadas al modelo por ciclo, τ los tokens medios de entrada y salida por llamada, y p el precio por token.
De ahí salen tres propiedades, y la tercera es la que importa:
- El coste es inversamente proporcional a la cadencia. Ciclos más cortos = más reactividad a coste proporcionalmente mayor. Tienes un dial explícito entre las dos cosas.
- Está acotado por ciclo, porque
τ_outno puede superar el límite de tokens de salida del modelo. No hay cola larga. - Y la buena:
C«lo fija cómo se ha partido la superficie de control en grupos de decisión (un puñado por ciclo), no el número de usuarios o peticiones servidas, de modo que el coste es independiente del tráfico y sigue siendo despreciable incluso en superficies de miles de millones de usuarios».
Las cifras que dan de los dos despliegues son casi cómicas de pequeñas —y conviene subrayar que son estimaciones a partir del tamaño de los prompts y los payloads, porque, como reconoce el propio pie de tabla, «las pipelines no registran el uso de tokens»:
| Despliegue | Llamadas/ciclo | Tokens entrada/llamada | Tokens salida/llamada |
|---|---|---|---|
| Presupuesto de recuperación | ~10 | ~1.500 | ~2.500 |
| Capacidad de servicio | ~8 | ~2.000 | ~2.500 |
Cada ciclo emite un puñado de llamadas de unos pocos miles de tokens, así que un despliegue de varios ciclos suma «del orden de 10⁶ tokens», lo que sitúa el coste de inferencia de extremo a extremo de cada despliegue «del orden de decenas de dólares estadounidenses — despreciable frente a las ganancias de engagement y los ahorros de coste operativo que produce».
Un millón de tokens. Contra millones de dólares anualizados de ahorro en el segundo caso. Esa asimetría no es magia del modelo: es la geometría de dónde lo enchufaste.
Y la frase que resume el cambio de oficio, literal del paper: «comprimiendo un ciclo de ajuste de varias semanas-ingeniero a unos pocos días autónomos, un tiempo de respuesta un orden de magnitud más rápido sin ningún ingeniero en el bucle».
La letra pequeña
Esta es la sección que a mí me interesa más, y la razón por la que este paper me gusta pese a todo lo que le falta. Es corto, es de workshop, y hay que leerlo por lo que demuestra y no por lo que sugiere.
| Lo que es fácil leer | Lo que dice el paper cuando lo trazas |
|---|---|
| «Mejoras del 0,13% al 0,77%, con solidez estadística» | No hay ni un intervalo de confianza, ni un p-valor, ni un N exacto en todo el paper. Lo único que hay es una etiqueta binaria en el pie de la Tabla 1: «neutral denota que no hay cambio estadísticamente significativo». Se infiere que el resto sí lo es, pero nunca se afirma celda por celda ni se da magnitud de incertidumbre. |
| «El LLM supera al ingeniero humano» | No hay ningún baseline competitivo. Ni contra un ingeniero, ni contra bandits, ni contra optimización bayesiana, ni contra RL. Solo A/B contra el control de producción. Lo que se demuestra es que el bucle mejora sobre una configuración fijada a mano y rara vez revisada — que es exactamente lo que los autores dicen. |
| «Un modelo frontera consiguió…» | El paper no nombra el modelo. Ni familia ni proveedor. Habla de «un modelo de lenguaje de propósito general», y «frontier-LLM» aparece solo como referencia de precios para estimar el coste. La cifra de decenas de dólares es una estimación con precios representativos, no una factura — y el pie de la Tabla 2 admite que los tokens tampoco se midieron: «las pipelines no registran el uso de tokens». |
| «Tres rondas, tres decisiones» | La ronda 3 «agrega varios ciclos de decisión y es la configuración desplegada». No es una vuelta: son varias. |
| «Corre solo» | «Aunque el bucle corre de forma autónoma, sigue operando bajo supervisión humana». Reforzar los guardarraíles automáticos para que esa supervisión «pueda reducirse» está declarado como siguiente paso natural. |
| «Sirve para cualquier palanca» | «Ambos estudios instancian el harness sobre una sola clase de decisión: la asignación con restricciones de los recursos de un recomendador entre sus componentes». Extenderlo a la lógica de recuperación y ranking está declarado como pendiente. |
Y una limitación que los propios autores marcan como problema abierto y que me parece la más honesta del lote: la evidencia viene de experimentos A/B, que miden efectos reales pero son «caros de ejecutar y específicos de su entorno». No existe todavía una forma estandarizada de evaluar optimización de sistemas guiada por agentes antes de desplegarla. Es decir: para saber si tu bucle funciona, de momento hay que soltarlo en producción.
Ah, y no hay código, ni página de proyecto, ni datos. Nada reproducible. La curiosidad final, para los que miramos estas cosas: el paper está clasificado en arXiv como cs.CL, lenguaje computacional. Ni cs.IR ni cs.LG. Un paper de recomendadores en la categoría de lingüística computacional dice bastante sobre en qué campo cree este equipo que está trabajando.
Qué me llevo a mi bucle
Quitando la escala, que no es replicable, aquí hay cinco decisiones de diseño que sí lo son y que voy a aplicar:
- Separa el plano. Antes de meter un modelo en algo, pregúntate si va en el camino de cada petición o en el de la configuración. Si va en el de la configuración, el coste deja de escalar con el uso y la latencia deja de importar. Casi siempre hay una versión de tu problema que vive en el plano de control.
- Haz las restricciones estructurales, no textuales. Todo límite que le pidas al modelo en el prompt es una sugerencia. Todo límite que impongas proyectando su salida sobre un conjunto factible es una garantía. Si tu agente tiene presupuesto, cuota o tope, ponlo en una función, no en un párrafo.
- Guarda decisiones con resultados, no solo observaciones. El almacén que hace que el bucle aprenda es el que empareja «lo que desplegué» con «lo que pasó después». Sin esa pareja tienes un agente con diario, no con memoria.
- Elige la cadencia según la latencia de tu señal.
kno se ajusta buscando el óptimo: se elige por cuánto tarda un efecto en ser visible. Y como el coste es inversamente proporcional ak, ese número es a la vez tu dial de reactividad y tu dial de gasto. - Espera la ronda mala. Si tu bucle mejora en todas las vueltas, sospecha del medidor. La ronda que se pasa de frenada y se corrige es la prueba de que la realimentación existe.
Veredicto
El patrón sí, la extrapolación no. Lo que CORAL demuestra es acotado y sólido: un agente en bucle cerrado, con memoria de sus propias consecuencias y con las restricciones metidas en la estructura, puede sostener el ajuste continuo de un sistema de producción mejor que una configuración fijada a mano y rara vez revisada, y por un coste que se pierde en el redondeo. Lo que no demuestra —y no pretende— es que el LLM sea la mejor herramienta para ese trabajo: falta el baseline que lo compare con los métodos clásicos de optimización con restricciones que llevan décadas haciendo justo eso.
Pero la lección arquitectónica aguanta entera, y es la que cierra esta serie mejor de lo que la cerré yo. La primera entrega dejó una fórmula: tu palanca es habilidad × claridad. La tercera le añadió un factor: juicio × topología. Este anexo añade el último, y es el que decide si el bucle puede salir de tu portátil:
superficie × cadencia. Qué diales puede tocar tu bucle, y cada cuánto puede medir lo que pasó al tocarlos.
Todo lo demás —el modelo, el prompt, la memoria, las herramientas— es implementación. Si la superficie de control es pequeña, el bucle no puede cambiar nada que importe. Si la cadencia es más rápida que la señal, el bucle aprende ruido. Y si no hay nadie midiendo el resultado en producción, entonces no tienes un bucle: tienes un agente escribiendo propuestas muy convincentes que nadie ha comprobado nunca.
La criatura salió del IDE. Resulta que fuera hay diales.
Ideas por encima de código; evidencia por encima de humo.
Referencias
- Azhar, M. R., Zhou, Y., Jiang, G., Wang, Y., Sharma, R., DeSousa, M., Liu, J., Guo, X., Zhang, L. y Fan, X. (2026). CORAL: An LLM-Native Harness for Production Recommender Systems. arXiv:2609.02730 [cs.CL], 2 de septiembre de 2026. Aceptado en el RecSys ’26 OARS Workshop.
- Entregas anteriores de la serie: La criatura que vacía tu backlog mientras duermes, El agente olvida, el grafo no y La criatura ya no hace cola: dynamic workflows y el salto de la cadena al grafo.

Deja una respuesta