
Esta semana ha sido de las que te dejan el lector de noticias en rojo. El 21 de septiembre salió Grok 4.7 y, al día siguiente, casi a la vez, llegaron Claude Opus 5.5, GPT-6 Sol, GPT-6 Luna y dos modelos nuevos de Xiaomi (aquí tienes la cronología completa). Modelos más grandes, más capaces y más caros de entrenar. Es la noticia que va a comentar todo el mundo, y con razón.
Pero la que a mí me hizo parar llegó una semana antes, de una empresa que probablemente no te suena. El 15 de septiembre, TypeSafe AI presentó Jev, un modelo que no escribe ni una sola palabra. Y lo presentó su fundador, Diogo Almeida, que estuvo en OpenAI desarrollando los métodos que acabaron detrás de ChatGPT, con una confesión que me parece de lo más honesto que he leído este año. En el post de lanzamiento cuenta que durante un tiempo pensó que los modelos de chat podían llevarnos a la AGI, y que con los años se le hizo evidente que faltaba algo muy grande.
Cuando uno de los que ayudó a construir el oráculo te dice que el oráculo no era el camino, merece la pena pararse a escuchar. Y a mí, escuchándole, se me fue la cabeza a dos libros que no tienen nada que ver entre sí: uno de psicología y otro de aprendizaje automático. De eso va este artículo.
Un modelo que no escribe
Jev no es un chatbot, y conviene entender bien qué hace porque ahí está todo el argumento.
Le pasas dos cosas. La primera es un estado: un ticket de soporte, un correo, el JSON que describe cómo está tu aplicación en ese momento. La segunda es una pregunta con sus respuestas posibles ya definidas por ti. Y te devuelve una probabilidad para cada respuesta. Nada más. Tiene tres tipos de pregunta: elegir una opción de una lista cerrada, situar algo en una escala ordenada, o responder sí o no con una probabilidad.
¿Por qué importa tanto quitarle el texto? Porque hoy, cuando metes un LLM dentro de un programa, le pides la respuesta en texto (o en un JSON escrito como texto), la parseas, la validas y cruzas los dedos para que no se invente un campo o se salga del formato. Jev no puede salirse del esquema, porque no genera nada: la respuesta solo puede ser una de las que tú definiste antes. TypeSafe lo describe como una especie de if inteligente: una decisión difusa que encaja en código normal, justo donde una regla escrita a mano se queda corta y una llamada a un LLM es demasiado lenta o cara.
Hay otra palabra que se repite mucho en el lanzamiento: calibrada. Una probabilidad calibrada es la que, cuando dice 80 %, acierta más o menos ocho de cada diez veces. Suena a detalle técnico y es justo lo contrario. Como recuerda el propio post, si un sistema acierta el 95 % de las veces pero no te avisa de cuándo está en el 5 % restante, no puedes automatizar nada con él. La confianza bien medida es lo que te deja decidir qué va solo y qué necesita a una persona.
Los números, siempre según TypeSafe: respuestas en 70–500 milisegundos frente a los 3–329 segundos que tardan los modelos de frontera, entre 40 y 200 veces más rápido en consultas con esta forma, y 0,042 dólares por millón de tokens de entrada con la salida gratis. En su web llegan a hablar de 193,6 veces más rápido y 444,6 veces más barato (de ahí sale el «400 veces» que circula por ahí), pero el propio post avisa de que esas cifras están en la parte alta de lo que se verá en producción. Me quedo con el rango, no con el titular.
Pensar rápido, pensar despacio
TypeSafe llama a esta familia System One Models, y el nombre no es casual: lo explican ellos mismos, viene de Pensar rápido, pensar despacio, de Daniel Kahneman.
Si no lo has leído, la idea cabe en un ejemplo. Si ves la cara de alguien enfadado, sabes que está enfadado sin pensarlo: no decides saberlo, simplemente lo sabes. Eso es el Sistema 1, rápido, automático, barato. Si te pido que multipliques 17 por 24, en cambio, tienes que pararte, sostener números en la cabeza y hacer la cuenta paso a paso. Eso es el Sistema 2, lento, deliberado, costoso. Kahneman se pasó media vida explicando que buena parte de lo que hacemos y decidimos lo resuelve el primero, y que el segundo es un recurso caro que activamos lo justo.
Los LLM que razonan en cadena, los que se piensan la respuesta durante segundos o minutos antes de dártela, son Sistema 2 de manual. Y la tesis de TypeSafe, que comparto bastante, es que la mayoría de decisiones que se toman dentro del software tienen forma de Sistema 1: ¿de qué va este ticket?, ¿es urgente?, ¿esto lo resuelve un script o lo tiene que ver una persona? Llevamos tres años alquilando un Sistema 2 carísimo para contestar preguntas de Sistema 1.
Un matiz que no quiero saltarme: en Kahneman, el Sistema 1 es también el que más se equivoca, el de los sesgos y los atajos. TypeSafe sostiene que un Sistema 1 artificial y calibrado puede ser más fiable que las alternativas. Es una apuesta interesante, pero de momento es eso, una apuesta.
Seis clones en dos días
Lo que pasó después del lanzamiento me parece casi más interesante que el propio Jev. La demanda fue tal que TypeSafe se quedó un rato sin poder servir su API, y mientras tanto la comunidad se puso a replicarlo en abierto. Latent Space llegó a contar seis clones en dos días: unos sobre ModernBERT, otros adaptando modelos Qwen y hasta uno que reaprovecha un modelo de difusión. Me quedo con dos.
El primero es Kev, de Jared Palmer. Su primera versión, Kev-0.5B, es un adaptador LoRA con una pequeña cabeza de decisión encima de Qwen2.5-0.5B, y se entrenó el 17 de septiembre en un portátil de Apple con 32 GB en aproximadamente una hora y tres cuartos. Una tarde. En cuestión de días quedó superado por Kev-0.8B, Kev-4B y Kev-9B, ya sobre bases Qwen3.5, con una receta encontrada tras unas 110 pruebas controladas. Y habla el mismo idioma que la API de TypeSafe: puedes escribir tu código contra Jev y mañana apuntarlo a tu propio servidor.
El segundo es Laya, de Convai Innovations, publicado el 18 de septiembre con licencia Apache 2.0. Está montado sobre ModernBERT-large, con 421 millones de parámetros (más una variante multilingüe de 322 millones), y responde en unos 33 milisegundos en una GPU T4, que no es precisamente de última generación. Por si te suena raro lo de BERT: es una familia de modelos que no generan texto palabra a palabra, sino que leen el texto entero de una vez y producen una representación de su significado. Justo lo que necesitas si lo que quieres es clasificar y no escribir. Por eso es tan rápido.
Y aquí viene, para mí, la línea más importante de toda la semana. La ficha de Laya es de una honestidad brutal: sin especializarlo, en decisiones tipadas acierta un 36 %, apenas por encima del azar y por debajo de responder siempre lo más común; afinado con los datos de entrenamiento de esa misma tarea, sube al 77 %. Sus autores lo resumen diciendo que Laya es una base rápida para especializar, no un motor de decisiones que funcione de serie.
Eso es exactamente lo que llevo tiempo pensando que va a pasar. Modelos pequeños, baratos de entrenar, que no valen gran cosa en genérico y valen muchísimo afinados para tu caso. Un portátil, una tarde y tus datos. La hiperpersonalización no es un extra de lujo en este modelo: es el diseño.
El libro que llevo años masticando
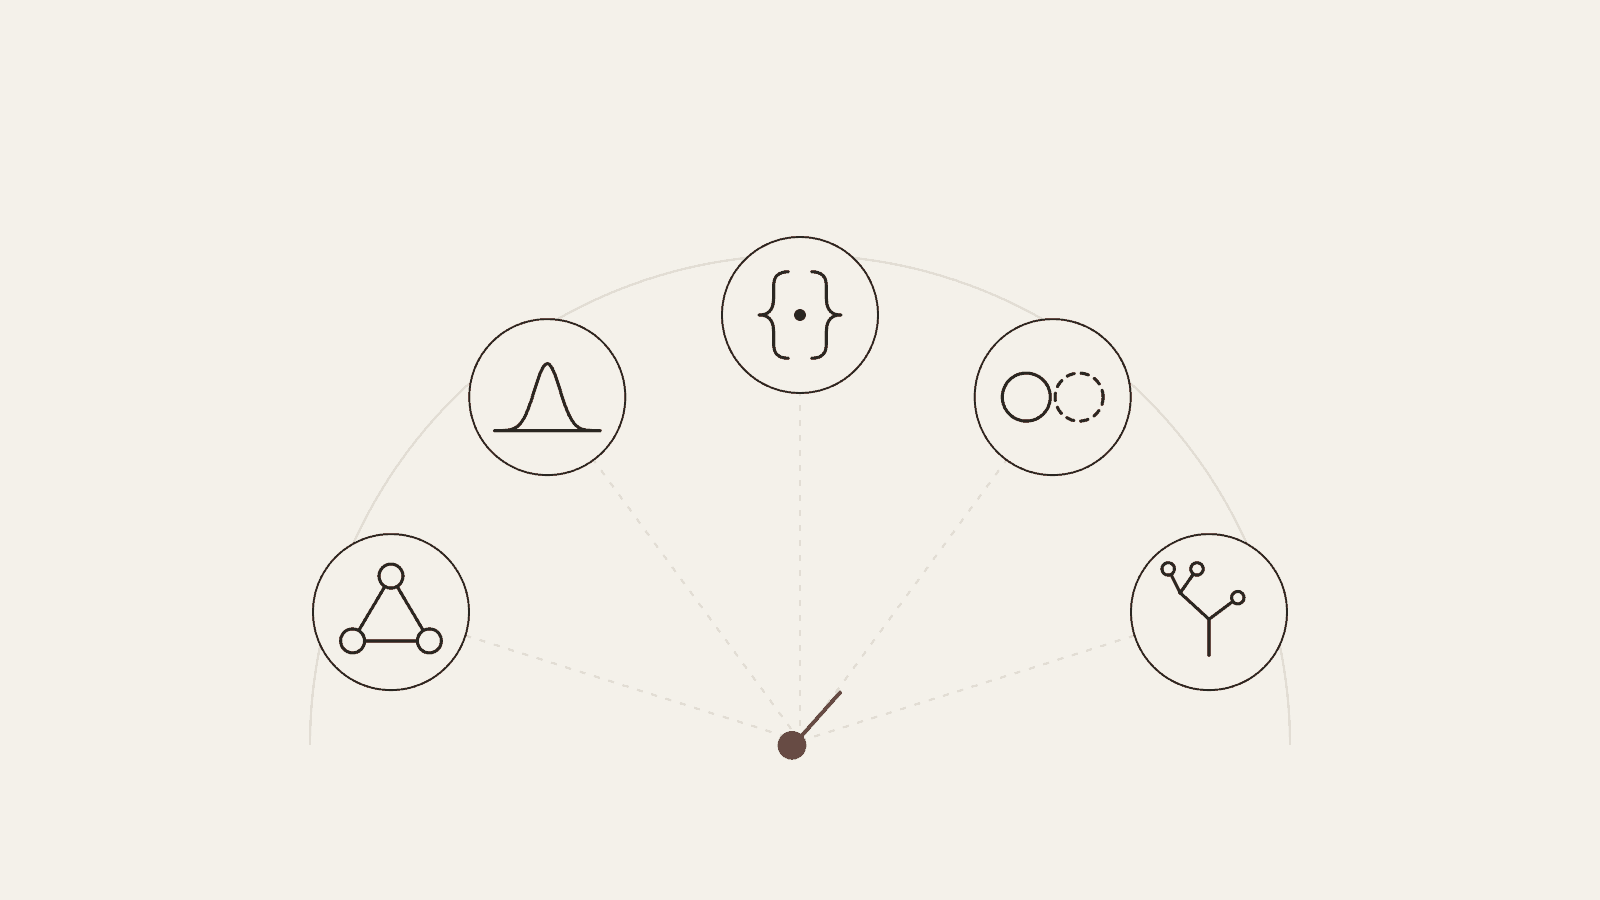
En 2015, Pedro Domingos publicó The Master Algorithm, uno de esos libros que me cambiaron la forma de mirar el campo. Domingos dividía el aprendizaje automático en cinco «tribus», cinco escuelas con su propia manera de entender qué es aprender y su propio algoritmo estrella:
- Los simbolistas, que ven el aprendizaje como lógica: deducir reglas generales a partir de ejemplos (su herramienta, la deducción inversa).
- Los conexionistas, que imitan cómo se ajustan las conexiones entre neuronas (la retropropagación, el motor de todas las redes neuronales).
- Los evolucionistas, que buscan soluciones generando variantes y quedándose con las que funcionan (la programación genética).
- Los bayesianos, para quienes aprender es actualizar grados de creencia a medida que llega la evidencia (la inferencia probabilística).
- Los analogistas, que razonan por semejanza: si esto se parece a aquello, probablemente se resuelva igual (las máquinas de vectores de soporte y, antes, el vecino más cercano).
Y hacía una apuesta explícita: que todo el conocimiento, pasado, presente y futuro, podría derivarse de los datos con un único algoritmo de aprendizaje universal. Pero ojo, porque aquí es fácil leerle mal. Domingos no esperaba que una tribu ganara a las demás. Lo que él defendía es que hacía falta un algoritmo que combinara lo mejor de las cinco, y su propio candidato, las redes lógicas de Markov, era un intento de casar la lógica de los simbolistas con la probabilidad de los bayesianos. El algoritmo maestro era una fusión, no una victoria.
Once años después, no tenemos ese algoritmo. Pero tengo la sensación de que las cinco tribus siguen ahí, muy vivas, solo que con nombre de producto en vez de nombre de escuela.
Las cinco tribus, once años después
Los conexionistas ganaron el suelo. Todo lo que se ha lanzado esta semana, de GPT-6 a Grok 4.7, es retropropagación escalada hasta donde llega el dinero. Pero es que Jev, Kev y Laya también son redes neuronales por dentro. La tribu conexionista no ganó una parte del mapa: ganó el sustrato sobre el que se construye todo lo demás.
Los bayesianos vuelven como exigencia. Jev no hace inferencia bayesiana en sentido estricto, pero su entrenamiento está pensado para que la única forma de maximizar la recompensa sea dar la probabilidad honesta (así lo explica también la ficha de Laya, que usa el mismo enfoque). Eso es el espíritu bayesiano de toda la vida: no me des un veredicto, dame un grado de creencia que pueda usar.
Los simbolistas están en el contrato. Fíjate en el nombre de la empresa: TypeSafe, seguridad de tipos. Antes de que el modelo vea nada, una persona ha declarado qué respuestas existen, qué forma tienen y qué significa cada una. Eso es conocimiento simbólico puro. Y lo mismo pasa con las ontologías, los grafos de conocimiento y las políticas que dicen qué puede hacer un agente y qué no. Nadie entrena eso con gradientes; alguien lo escribe.
Los analogistas viven en la memoria. Cada vez que un sistema recupera los documentos más parecidos a una pregunta (lo que llamamos RAG) o busca en una base de datos vectorial, está usando el truco más viejo de esta tribu: el vecino más cercano. Esto se parece a aquello que ya resolví, así que empiezo por ahí. Solo que a escala de millones.
Los evolucionistas trabajan en el taller. Aquí no hay programación genética en sentido literal, pero el patrón está clarísimo: muchas variantes a la vez, pruebas y descarte. Kev llegó a su receta actual tras unas 110 pruebas controladas, y lo desarrolló con ayuda de un agente de programación. El ecosistema entero hizo lo mismo a otra escala: seis arquitecturas distintas compitiendo por el mismo hueco en dos días. Ya veremos cuáles siguen aquí dentro de un año.
La fusión ocurrió, pero no donde Domingos la buscaba
Aquí es donde el mapa se pone interesante, y donde quiero afinar un poco la analogía para que no quede demasiado bonita.
Domingos buscaba la fusión dentro del algoritmo: una sola matemática que aprendiera como aprenden las cinco tribus a la vez. Lo que ha pasado es otra cosa. Abajo, en el sustrato, sí ha habido unificación: casi todo son redes neuronales entrenadas por descenso de gradiente. Pero arriba, en lo que cada pieza hace dentro de un sistema, la diversidad ha vuelto con fuerza. Las tribus ya no son métodos que compiten; son papeles que se reparten.
El propio Jev es el mejor ejemplo: cuerpo conexionista, contrato simbolista y salida bayesiana. Tres tribus en un solo producto. La fusión existe, pero no ocurre en la ecuación. Ocurre en la interfaz.
Y queda una pieza que no encaja en ninguna tribu: la que decide quién toca en cada momento.
El director que no toca ningún instrumento
Piensa en cómo se resuelve hoy algo tan normal como una incidencia que entra por correo. Lo trivial lo resuelve código de siempre, sin ningún modelo. Un modelo de Sistema 1 decide en milisegundos de qué va, si es urgente y si hay demasiada incertidumbre como para seguir sin una persona. Solo la minoría difícil llega al Sistema 2, al LLM grande que razona, planifica y escribe. Es el patrón en cascada que ya se está proponiendo alrededor de Jev: el código hace lo que puede, el modelo rápido enruta y el modelo grande se queda con lo difícil. Y alrededor de todo eso, un grafo con las reglas de la casa (simbolistas) y una memoria de casos parecidos (analogistas).
Ninguno de esos instrumentos es el algoritmo maestro. Lo más parecido es el director: la capa que decide qué instrumento entra, cuándo y con qué partitura. Es lo que buena parte del sector está empezando a construir en forma de sistemas operativos agénticos: una capa capaz de lanzar agentes contra casos de uso concretos, llevarlos de la idea a producción y elegir, en cada paso, con qué pieza se resuelve. Para mí, ahí está el núcleo fuerte de los próximos años. No en tener el modelo más grande, sino en saber dirigir.
Ahora bien, hay una diferencia importante con lo que Domingos imaginaba, y no quiero pasarla por alto. Su algoritmo maestro era, ante todo, un algoritmo que aprende. El director de hoy, en cambio, casi no aprende: es lógica escrita a mano más un LLM que improvisa sobre unas instrucciones. El día que el director aprenda a componer la orquesta él solo, a partir de la experiencia y no de un prompt, estaremos más cerca de lo que Domingos soñaba que con cualquier modelo de frontera nuevo. Esa, para mí, es la pregunta interesante de la próxima década.
Por qué creo que el vibe coding es una fase
Todo esto me lleva a algo que llevo meses rumiando. El vibe coding, eso de describirle a un agente lo que quieres y que te devuelva una aplicación entera, es la forma más pura del mito del oráculo: una mente grande a la que se lo pides todo. Funciona, y para prototipar es una maravilla. Pero generar código con agentes ya es el pan de cada día. Los benchmarks de programación y los programas construidos por agentes han dejado de ser el problema que quita el sueño. Y cuando algo se vuelve cotidiano, deja de ser donde se juega la partida: pasa a ser un ingrediente.
Lo que veo venir es hiperpersonalización. Empresas que construyen sus propias aplicaciones para sus propias necesidades, sobre modelos pequeños afinados para casos concretos, entrenados sin presupuestos de cómputo desorbitados y apoyados en capas de decisión rápidas como las que acabamos de ver. En ese mundo, la pregunta deja de ser «¿cuál es el mejor modelo?» y pasa a ser «¿cómo compongo mi orquesta?»: qué decisiones son de Sistema 1, cuáles merecen un Sistema 2, qué conocimiento tengo que declarar y qué memoria quiero conservar.
No creo que el vibe coding desaparezca porque falle. Creo que desaparecerá como categoría porque se disolverá dentro del director, igual que hoy nadie dice que «usa un compilador» como si fuera una actividad aparte.
El oráculo único era la pregunta equivocada
La carrera por escalar y la persecución de la AGI parten de una imagen muy concreta: una sola mente, lo bastante grande, que lo resuelve todo. Y lo curioso es que quienes mejor conocen esa imagen por dentro están empezando a apostar por otra cosa. Almeida dejó el chat para construir decisiones. Yann LeCun dejó Meta para fundar AMI Labs, que levantó 1.030 millones de dólares para construir modelos del mundo con su arquitectura JEPA en lugar de modelos de lenguaje. La frontera no se está concentrando: se está repartiendo. Modelos enormes para razonar, modelos minúsculos para decidir, modelos del mundo para entender la física.
Y quizá no debería sorprendernos tanto. Kahneman nos explicó hace quince años que ni siquiera nuestra propia cabeza funciona como un solo sistema: hay un modo rápido y otro lento, cada uno bueno en lo suyo, repartiéndose el trabajo. Domingos, por su parte, necesitó cinco tribus para describir qué significa aprender. No sé muy bien por qué esperábamos que la inteligencia de una máquina sí fuera una sola cosa.
Si la inteligencia nunca fue una cosa, sino varias maneras distintas de resolver problemas más algo que decide cuál usar, entonces la AGI entendida como un único oráculo no es un destino lejano. Es una pregunta mal planteada. La buena pregunta es otra: cómo componemos, coordinamos y nos fiamos de muchos mecanismos distintos a la vez.
La letra pequeña
- Las cifras de Jev son las que publica TypeSafe, no una medición independiente. Sus evaluaciones de flujos de trabajo las diseñó su propio equipo y usan como referencia la media de GPT-6 Astra y Fable 5.1; lo reconocen ellos mismos en el post. Y el 193,6x / 444,6x de su web es, por su propia admisión, la parte alta.
- Kev y Laya tienen días de vida. Son señal temprana, no tecnología asentada, y Laya sin afinar rinde por debajo de responder siempre lo más común.
- El mapa de las cinco tribus es mío, no de Domingos, y es un mapa de funciones, no de mecanismos: por debajo casi todo es una red neuronal. Un bayesiano purista diría, con razón, que calibrar no es inferir.
- Domingos no escribió sobre Jev, sobre agentes ni sobre 2026. Lo que hago aquí es poner su marco a prueba contra una semana real, no presumir de profecía.
- En Kahneman, el Sistema 1 es el que más se equivoca. Que un Sistema 1 artificial pueda ser más fiable es la apuesta de TypeSafe, no un hecho.
El veredicto
El algoritmo maestro, no. La orquesta, sí. Y la partitura, quién decide qué, cuándo y con qué instrumento, es donde creo que está el trabajo de verdad de los próximos años.
Ideas por encima de código; evidencia por encima de humo.

Deja una respuesta